"Educar no es llenar un recipiente, sino encender una hoguera ..."

por amor a las matemáticas .....

por amor a las matemáticas .....
"Yo vivo de preguntar, saber No puede ser lujo" (Sylvio Rodríguez)

Guías Mates Asociadas

Para contactarte conmigo:

mail: psumates2009@gmail.com

Rivers de Ennio Morricone

Pienso en MATEMÁTICAS ..... pero NO sólo en esto
Mostrando entradas con la etiqueta Biología. Mostrar todas las entradas

martes, 25 de agosto de 2009

Matemáticas y ADN


APLICACIONES EN BIOLOGÍA MOLECULAR

El ADN, el material genético más importante en la mayoría de los organismos, se ve habitualmente como una doble hélice, en la que dos cadenas de nucleótidos complementarios se enrollan a lo largo de un eje común. El eje de esta hélice doble no es lineal, sino curvo.

La doble hélice puede moverse en el espacio para formar una nueva hélice de orden mayor; en este caso se habla de ADN sobreenrollado. Parece que una gran parte de los ADN conocidos se muestran de esta manera sobreenrollada en algún momento del ciclo de su vida.

El ADN circular sobreenrollado es una doble hélice de moléculas, donde cada cadena de polinucleótidos forma un anillo. Cada propiedad física, química y biológica del ADN (comportamiento hidrodinámico, energético, etc.) es afectado por la circularidad y las deformaciones asociadas al sobreenrollamiento.

La comprensión del mecanismo del sobreenrollamiento y las consecuencias de estas características estructurales para el ADN, es un problema matemático bastante complejo, que hace intervenir dos ramas de la matemática: la topología y la geometría diferencial.

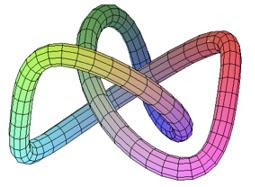
Para estudiar matemáticamente el sobreenrollamiento, hay que construir un modelo en el que la estructura se represente como un estrecho lazo torcido de espesor infinitesimal. Por ello, es necesario describir los nudos y encontrar características esenciales que permitan distinguirlos -en otras palabras- clasificarlos sin riesgo de confusión.

Estas características, que deben permanecer inalterables a lo largo de la deformación del nudo, se llaman invariantes del nudo. En el estudio de la replicación del ADN celular, se encuentran sacos de nudos. El ADN está más o menos enrollado sobre si mismo y en el momento de la replicación se forman nudos que están controlados por proteínas que se llaman topoisomerasas. Conociendo mejor estas proteínas y su interacción con el ADN, se abren nuevas perspectivas en la lucha contra las enfermedades genéticas, los virus, las bacterias o el cáncer.

miércoles, 17 de junio de 2009

GRIPE A: ¿Susto (importante) o devastadora pandemia? Las matemáticas buscan la respuesta.

La pregunta del millón ahora mismo es ¿Qué pasará con la gripe A? ¿Se convertirá en una pandemia devastadora o se quedará en un importante susto? También podría ser un aviso: la gran epidemia de 1918, que mató a 70 millones de personas, estuvo precedida por una oleada más suave, unos meses antes. La única manera de responder a estas preguntas, o al menos de intentarlo, es recurrir a modelos. Matemáticos españoles que trabajan en modelización de epidemias admiten que el poder predictivo de estas herramientas es aún bajo. Pero el avance es rápido. Lo mismo que el conocimiento sobre los números que definen la actual epidemia de gripe A.

Joan Saldaña, biólogo y matemático de la Universidad de Girona que trabaja en modelización de epidemias, señala al brote de 2003 de una nueva neumonía, el SARS, como el estreno de la ‘era moderna’ de los modelos matemáticos para epidemiología a gran escala. Las predicciones ‘tradicionales’ en esa ocasión fallaron bastante –se dijo que la epidemia de SARS sería más grave de lo que fue-, y fue entonces cuando entró en juego una nueva herramienta matemática más sofisticada, el estudio de las redes complejas, que sí produjo estimaciones más acertadas.

Los modelos basados en redes complejas usan parámetros no sólo de la propia enfermedad, sino de la sociedad en que ésta se manifiesta. El punto de partida es una obviedad: no es lo mismo un brote de Ébola en un poblado aislado en África que uno de gripe aviar en el superpoblado sureste asiático. Pero lo difícil es afinar: definir la estructura social en México y compararla con la de Madrid o Nueva York. ¿Qué medios de transporte usa la gente cada mañana? ¿Se compra en comercio local, o en grandes centros comerciales? Son parámetros complejos de medir, y además hay que tener en cuenta ‘sorpresas’ -¿y si durante el brote de Ébola hay un antropólogo en el poblado que a las pocas horas de infectarse vuela a Nueva York?-. Todo esto hace que los modelos, por ahora, no puedan predecir bien la evolución de una pandemia. “Más bien pasa como en la economía, que explican a posteriori por qué pasa lo que pasa”, dice Saldaña.

Sin embargo los modelos sí que resultan ya muy útiles a la hora de decidir qué medidas de contención de una epidemia. “Los modelos en epidemiología sí son de gran importancia para el estudio del impacto de distintas medidas que se pueden aplicar para el control de la epidemia (cuarentenas, estrategias de vacunación, etc.)”, señala Saldaña.

En cualquier caso el SARS demostró que, si se quiere mejorar los modelos, hay que incluir variables demográficas. Mientras tanto, es fundamental concentrarse en conocer mejor los números que ‘definen’ la propia epidemia. En el caso de la actual, estos son algunos.
Los números de una epidemia

El ‘número básico reproductivo’, o R0, es el número de nuevos casos a los que dará lugar cada persona infectada. Las estimaciones preliminares de expertos a ambos lados del Atlántico coinciden en general. Ira Longini, epidemiólogo de la Universidad de Washington citado en Nature (7 de Mayo de 2009), se ha basado en datos de un brote en un colegio de Nueva York para dar un R0 de 1,4. Y el 11 de Mayo se publicó en Science un trabajo dirigido por el matemático Neil Ferguson, director del centro de modelización epidemiológica del Imperial College London, concluyendo que cada persona con gripe A podría contagiar a entre 1,2 y 1,6. Es un número inferior al de epidemias pasadas de gripe (el R0 de la gripe de 1918 se ha estimado en menos de 4). Otro número clave es la tasa de mortalidad. Hay aún pocos datos de todo el mundo para tener una buena estimación. Además en México, donde más casos se han dado, los datos no se consideran fiables. Pero en principio los expertos dan una tasa de mortalidad de 0,4%, que podría oscilar entre el 0,3% y el 1,5%. Es inferior a la de la gripe de 1918.

El tiempo de incubación, antes de que un infectado empiece a infectar a otros, también es importante. En el ‘News’ de Nature se da una estimación de entre 3 y 5 días, probablemente más cerca de 3. Cuanto mayor sea R0, y más bajo el tiempo de incubación, más rápido se propaga la enfermedad y más difícil es de controlar.
Otros parámetros importantes son la vía de transmisión y saber si una parte de la población se contagia más fácilmente. En esto último la gripe A es aún un misterio, dice en Nature Stephen Morse, epidemiólogo de la Universidad de Columbia, en Nueva York (EEUU), pero al menos hasta el 4 de Mayo el 62% de casos en EEUU eran en menores de 18 años. “Una mayor virulencia entre adultos jóvenes podría implicar un recrudecimiento de la epidemia”, afirma Morse.

A la luz de los datos de que ya se dispone, Ferguson (Imperial College London), dice que la gripe A “ha estado siguiendo hasta ahora un patrón muy similar al de la pandemia de gripe de 1957, en cuanto a la proporción de población que se está infectando y el porcentaje de casos potencialmente fatales (...) Lo que vemos no es lo mismo que la gripe estacional y aún hay motivos para la preocupación –esperamos que esta pandemia al menos duplique la carga sobre nuestros sistemas sanitarios-. Sin embargo, esta modelización inicial sugiere que el virus H1N1 no se transmite tan fácilmente ni es tan letal como la pandemia de 1918”. Sólo queda esperar que los modelos no se equivoquen.
(Tomado del Blog para ANTI-Matemáticos, relativo a I-Math)

viernes, 31 de octubre de 2008

Geometría Fractal y Ecología: Focas, Mejillones, Bacterias y Costa


La geometría fractal y los diversos constructos matemáticos que se basan en ella son fuente de asombro y admiración por parte de los curiosos, pero también tienen múltiples aplicaciones en muchas del saber, incluidas la biología y ecología. Ejemplos tan manidos en biología como sorprendentes son la geometría fractal de los helechos, los alveolos pulmonares o los capilares sanguíneos. Pero hay muchos otros aspectos de la naturaleza que se pueden observar desde el punto de vista de la fractalidad, como el uso diferencial del territorio.


Supongamos que 20 focas necesitan una determinada longitud de costa para criar, por ejemplo 1 metro/foca. Su escala de medida está relacionada con su tamaño, y para esas focas la cantidad de recurso disponible es, supongamos, una cómoda playa de, a ojo, 20 metros. Sin embargo, en esos mismos “20” metros de costa, un mejillón mucho más pequeño percibe no 20, sino 120. Y no es que el mejillón “perciba” 120 metros, sino que “hay” realmente 120 metros de costa (medidos a otra escala). Y si es una bacteria que se fija a las rocas, no tendrá 120 m., sino kilómetros de costa en esa misma playa que para una foca son solamente 20 metros.


Es decir: con una geometría clásica podríamos pensar que en la naturaleza un organismo 10 veces más pequeño que otro estará en una densidad de individuos 10 veces mayor en un mismo lugar. ¡Y sin embargo esto casi nunca ocurre!: las especies de pequeño tamaño presentan una densidad de individuos casi siempre bastante (o muy) superior a la que les correspondería según la geometría clásica.


Para resolver esta cuestión y otras la geometría fractal es, hoy en día, una herramienta indispensable para los estudiosos de los ecosistemas.


(Tomado de Genciencia, misma cuestión respecto del texto que viene)

Un clásico de Biología Celular:Un glóbulo blanco persiguiendo a una bacteria


¿Qué es lo que estamos viendo?

Se trata de un neutrófilo (un tipo de glóbulo blanco, la defensa de nuestro organismo), persiguiendo y finalmente fagocitando a una bacteria. Sí, aunque parezca extraño, el bueno es el grandullón y el malo la cosa chiquitita que huye despavorida.

jueves, 3 de julio de 2008

Genoma y Ancestros Comunes (Paenza)

Genoma y ancestros comunes.
Los “bordes” que supuestamente definen cada ciencia son cada vez más borrosos y el hombre requiere de poder usar todas las herramientas a su alcance, donde las etiquetas poseen cada vez menos sentido. En lugar de decir: “éste es un problema para un físico o para un ingeniero o un arquitecto o un biólogo o un matemático”, uno debería decir: tengo este problema. ¿Cómo lo resolvemos? Pensemos juntos. Como consecuencia, el avance llega solo. O más fácil.

El texto que sigue muestra cómo los vasos comunicantes que generaron biólogos y matemáticos que trabajan en la frontera del conocimiento, permitieron poner en evidencia (una vez más) la existencia de ancestros comunes.

Durante 2005, en una charla que manteníamos en un café de la Facultad de Exactas (UBA) con Alicia Dickenstein (matemática y una de mis mejores amigas, una persona que claramente tuvo una incidencia muy positiva en mi vida), ella me comentó acerca de un trabajo muy interesante que involucró a biólogos y matemáticos. Más precisamente, me contó el resumen del trabajo “The Mathematics of Phylogenomics”, escrito por Lior Pachter y Bernd Sturmfels, del Departamento de Matemática de UC Berkeley.

Desde el momento en que, en el 2003, se completó el Proyecto Genoma Humano (HGP, de acuerdo con su sigla en inglés, Human Genome Project), comenzó también la carrera por conocer e identificar a nuestros antepasados, y saber con quiénes compartimos ese “privilegio”. El proyecto, que duró más de trece años, permitió identificar los (aproximadamente) entre 20.000 y 25.000 genes del genoma humano, y determinar las secuencias de los 3.000 millones de pares de bases químicas que lo componen. Es decir, es como si uno tuviera un alfabeto que consista en nada más que cuatro letras: A, T, C y G (las iniciales de A = Adenina, T = Timina, C = Citosina, G = Guanina).
El ADN de una persona es algo así como su cédula de identidad.
Ahí está escrita toda la información necesaria para el funcionamiento de sus células y sus órganos. En esencia, en una molécula de ADN está inscripto todo lo que podemos ser, nuestras particulares aptitudes y capacidades, y algunas de las enfermedades que podemos padecer. No obstante, es la combinación de esa información con el aporte del ambiente lo que hace que cada uno de nosotros sea único.


Esa doble hélice es una especie de serpentina que tiene escritas dos tiras enfrentadas de largas cadenas de esas cuatro letras.

Pero, además, posee una particularidad: si en una de las tiras, en un lugar hay una letra A, entonces en el lugar correspondiente de la otra tiene que haber una letra T, y si hay una C, entonces en la otra tiene que haber una G. Es decir que vienen apareadas. (De hecho, una forma de recordar esta particularidad, entre los amantes del tango, es usar las iniciales de Aníbal Troilo y Carlos Gardel.) Ahora bien, ¿a qué viene todo esto que parece más asociado a un artículo sobre biología molecular que a algo que tenga que ver con la matemática? En el artículo que mencionamos de Lior Pachter y Bernd Sturmfels, y también en el libro Algebraic Statistics for Computational Biology (Cambridge University Press, 2005), los autores estudiaron una situación muy particular.
Miren esta porción de ADN:

TTTAATTGAAAGAAGTTAATTGAATGAAAATGATCAACTAAG

Son 42 letras, en el orden en el que están escritas. Para decirlo de otra manera, sería como una palabra de 42 letras.

Esta “tira” del genoma fue encontrada (después de un arduo trabajo matemático y computacional de “alineación” de las distintas secuencias) en algún lugar del ADN de los siguientes vertebrados: hombre, chimpancé, ratón, rata, perro, pollo, rana, peces… Si uno tirara un dado, que en lugar de tener las seis caras convencionales, tuviera sólo cuatro lados, rotulados A, C, G, T, la probabilidad estimada de que esta secuencia de 42 letras apareciera en ese orden es de 1 dividido por 1050. Es decir, la probabilidad de que esto haya ocurrido por azar es aproximadamente igual a: 10-50 = 0,00000…0001. Para decirlo de otro modo, el número empezaría con un cero, luego de la coma habría cincuenta ceros, y sólo entonces un número uno. Justamente, la probabilidad de que esto ocurra es tan baja que permite a los autores del artículo conjeturar que todos ellos tuvieron un antepasado o un ancestro común (probablemente hace unos quinientos millones de años), que ya poseía esa secuencia de 42 bases, que fue heredada intacta a todos los descendientes de las distintas ramas de vertebrados. Por lo tanto, si bien uno no puede hablar de certeza, la probabilidad de que el hombre tenga el mismo origen que un pollo, o un perro, o un ratón (ni hablar de un chimpancé), es altísima.
sábado, 28 de junio de 2008

Uno de Hackers ..... DIVERTIMENTO

Señor, descubrieron el código del genoma humano
Malditos hackers!! voy a tener que cambiar la contraseña !!!
- - - - -
¿Qué es el Genoma?
GENOMA: Todo el material genético en una célula u organismo. Se le conoce como "el libro de la vida", "el manual del hombre", "el código de los códigos" y contiene riquezas de valor incalculable. En su libro Genoma, Matt Ridley (1999) señala que el genoma "es un libro inmenso, una receta de longitud desmesurada". A principios de los años noventa se organizó en los Estados Unidos el "Proyecto Genoma Humano", PGH, el más ambicioso, caro y polémico de la historia biología, dotado con 3.000 millones de dólares para determinar el "manual de instrucciones completo del ser humano" leyendo la secuencia precisa de los tres mil millones de bases químicas (A, C, G y T) de su ADN. Tanto fue el impacto de los primeros hallazgos que los editores de la revista Nature lanzaron en abril de 1992 la nueva revista Nature Genetics. Allí se comenzaron a conocer las identificaciones de muchos genes causantes de enferme devastadoras como la distrofia muscular, el mal de Alzheimer y el cáncer de mama . Comenzar a descifrar el genoma humano pasó a ser un asombroso que ha sido equiparado con los grandes avances tecnológicos, a invención de la rueda hasta la del hombre a la llegada del hombre a la Luna. Gracias a este proyecto, el ADN pasó de molécula inerte a ser el mapa del determinismo biológico, en el manual del ser humano. Eric Lander, investigador del Whitehead Institute (EE.UU.), comparó el PGH con la tabla periódica, el principal instrumento organizador de los elementos químicos. "El PGH intenta producir la tabla periódica de la biología, pero no con 100 elementos, sino con 100.000 genes. No es un rectángulo que refleja valencias, sino una estructura en forma de árbol que describe las afinidades ancestrales y funcionales que presentan los genes humanos". (Más tarde se precisó que no eran cien mil sino cerca de veinticinco mil los genes comprometidos).